PythonFastAPIpgvectorQdrantFastMCPGroq CloudLlama 3.3 70BClaude Haiku 4.5OCRReactDocker
Instances
- chat.imane.ai — en ligne
chat.afred.ai— seconde instance, enregistrement DNS à publier
Fonctionnalités
L’interface, baptisée Imane — assistant médical intelligent, expose le RAG à travers cinq entrées :
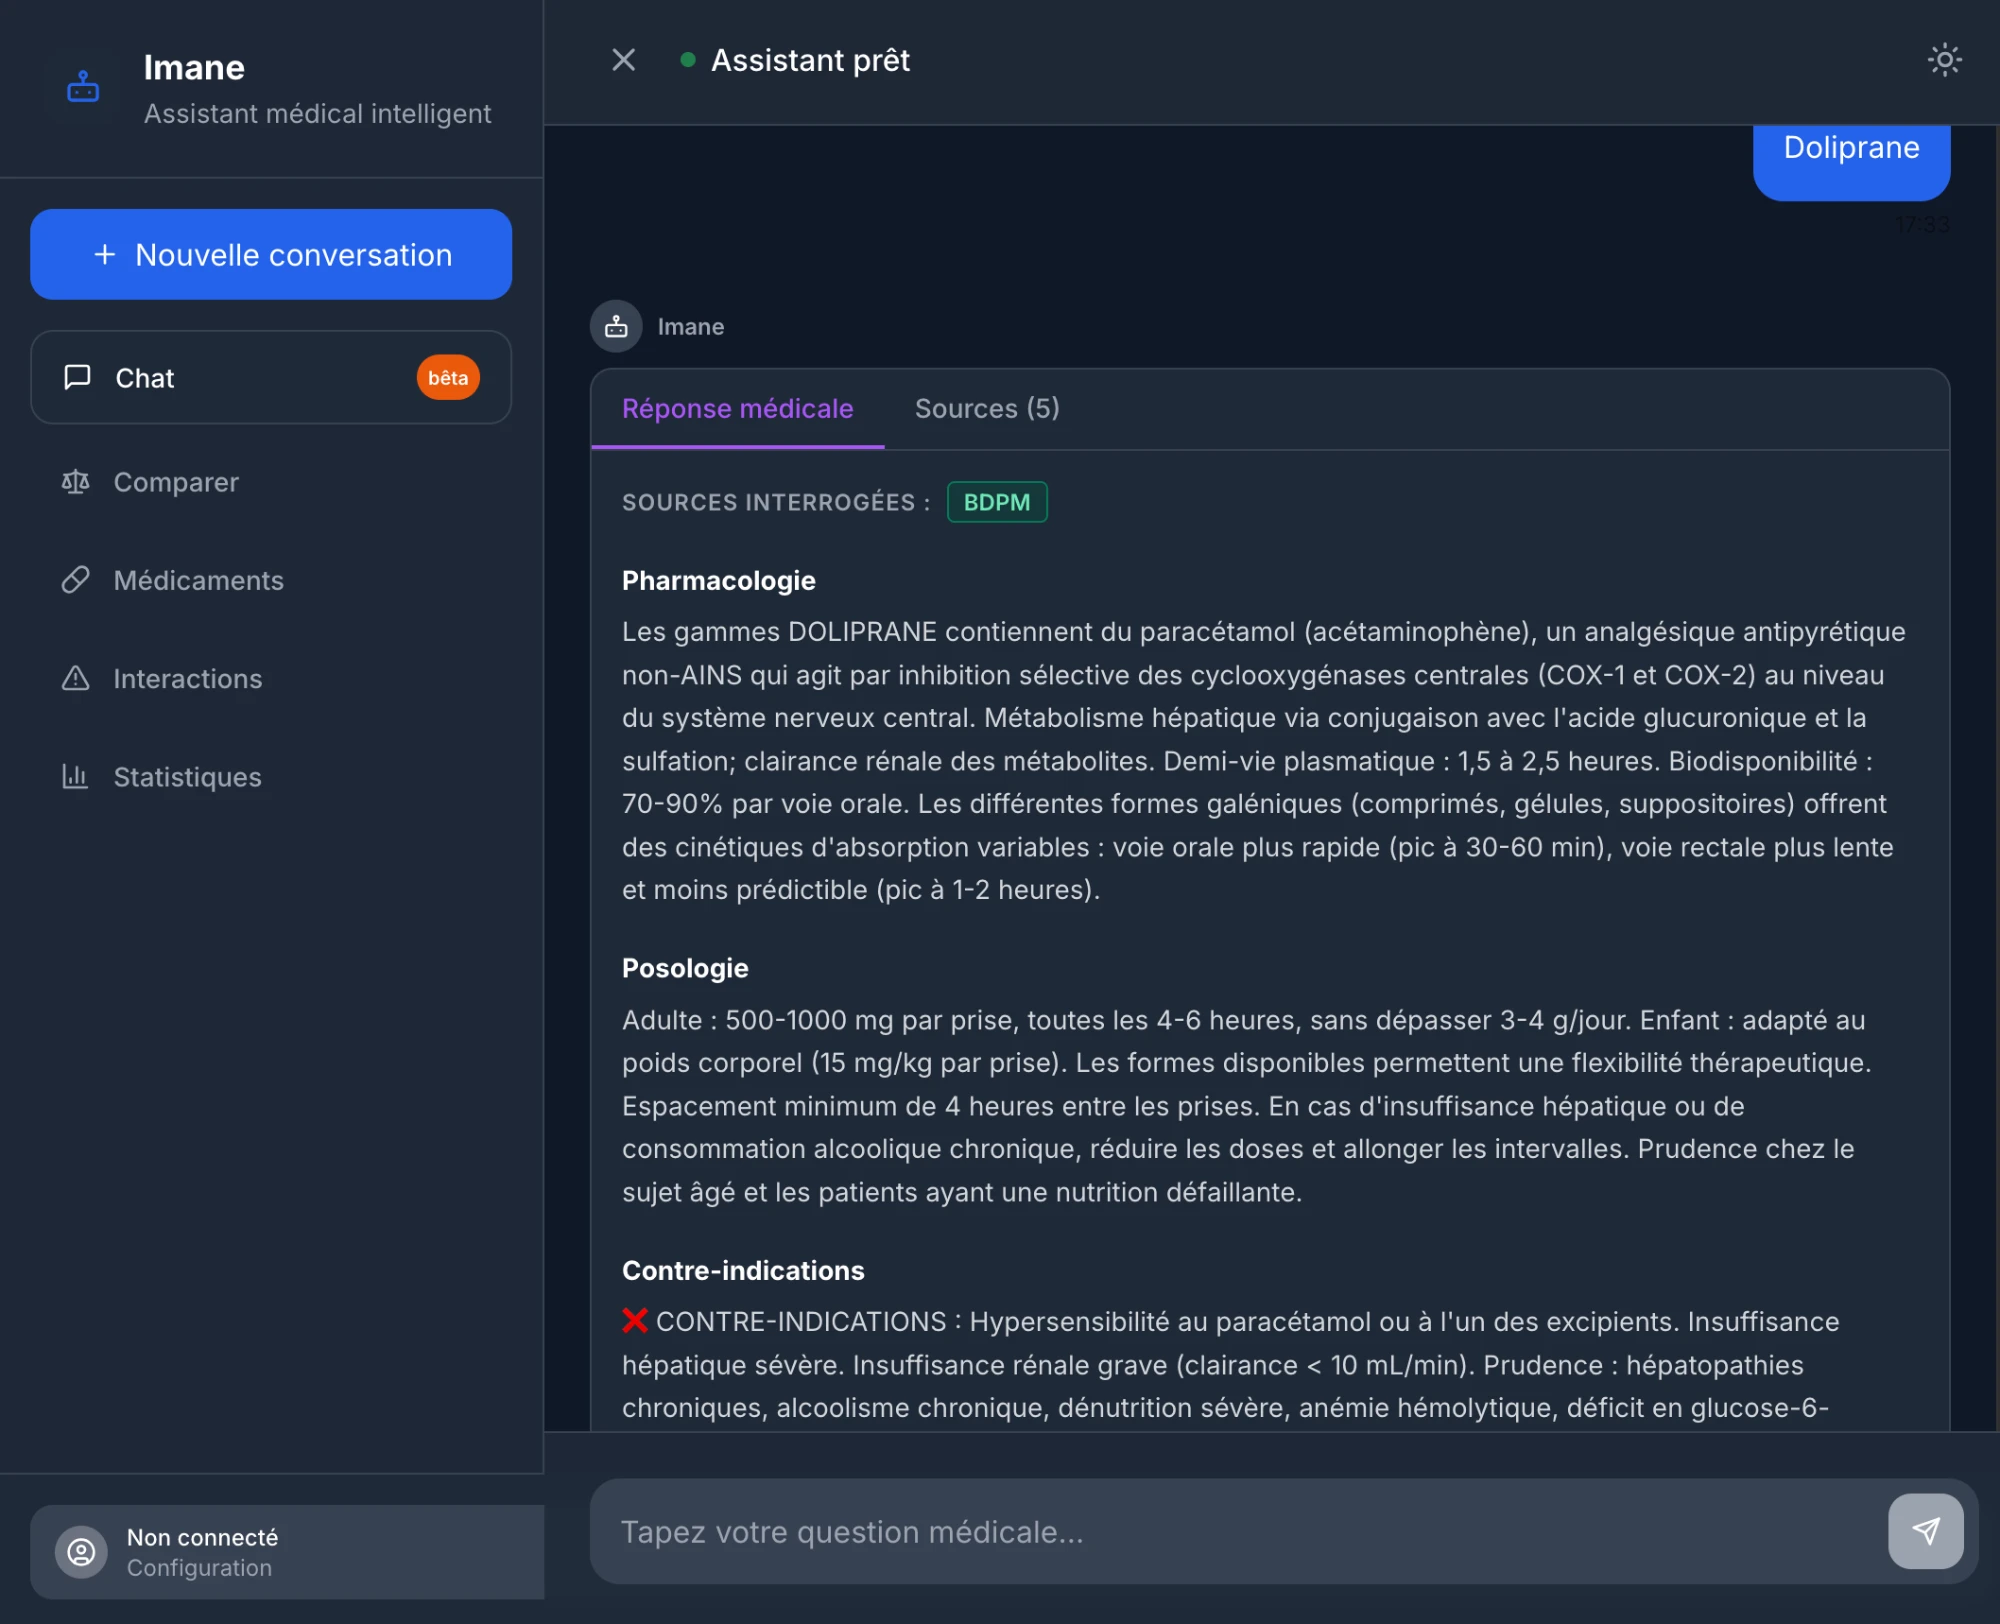
- Chat : questions en langage naturel sur les médicaments, les symptômes, la prévention et les premiers secours. Chaque réponse est structurée (pharmacologie, posologie, contre-indications, surveillance) et accompagnée d’un onglet Sources, qui cite les documents interrogés — la BDPM, base de données publique des médicaments, est signalée explicitement.
- Comparer : comparaison de deux à cinq médicaments selon un aspect choisi (effets secondaires, interactions…). La synthèse produite met en regard mécanismes d’action, profils de sécurité, contre-indications, toxicité hépatique et rénale, interactions médicamenteuses, surveillance requise, puis une conclusion clinique.
- Médicaments, Interactions et Statistiques : consultation directe du corpus indexé.
Le parti pris est la traçabilité : aucune réponse n’est rendue sans les sources qui la fondent, condition d’usage d’un assistant sur un domaine médical.
Objectif
Permettre d’interroger un corpus de documents cliniques en langage naturel, sans que le praticien ait à connaître la structure des documents.
Réalisation
- Indexation vectorielle via
pgvectorpuis Qdrant, avec comparaison des deux approches. - Génération multi-modèles : Llama 3.3 70B servi par Groq Cloud et Claude Haiku 4.5, routés selon la requête. Les latences moyennes par modèle sont suivies séparément, l’écart entre les deux étant d’un facteur proche de cinq.
- Extraction automatisée par OCR depuis des ordonnances en PDF et JPG.
- Exposition d’un serveur MCP (FastMCP) et de sa documentation d’API, pour rendre le RAG consommable directement par des agents IA — et pas seulement par l’interface web.
Back-office : gouvernance et observabilité
Un domaine médical interdit de livrer un assistant sans filet. Le back-office Medical RAG existe pour ça :
- Gouvernance : les réponses sont signalables et passent en file de revue (à relire, relu et résolu). Les requêtes n’ayant remonté aucun document sont isolées comme suspectes — c’est le symptôme typique d’une réponse inventée.
- Observabilité : volume de requêtes, taux de succès, latence moyenne et maximale, taux de cache, journal d’erreurs. Le suivi par modèle permet d’arbitrer entre coût, latence et qualité.
- Usage réel : médicaments les plus interrogés et répartition des opérations (interrogation de médicament, requête sans document, requête avec génération), qui indiquent où le corpus est insuffisant.
- Clés d’API à rôles : accès client distinct du rôle professionnel de santé, avec date d’expiration — le RAG est consommé par des applications tierces autant que par l’interface web.
Stack
Python, FastAPI, pgvector, Qdrant, Groq Cloud (Llama 3.3 70B), Claude Haiku 4.5, OCR, React, Docker.
L’assistant
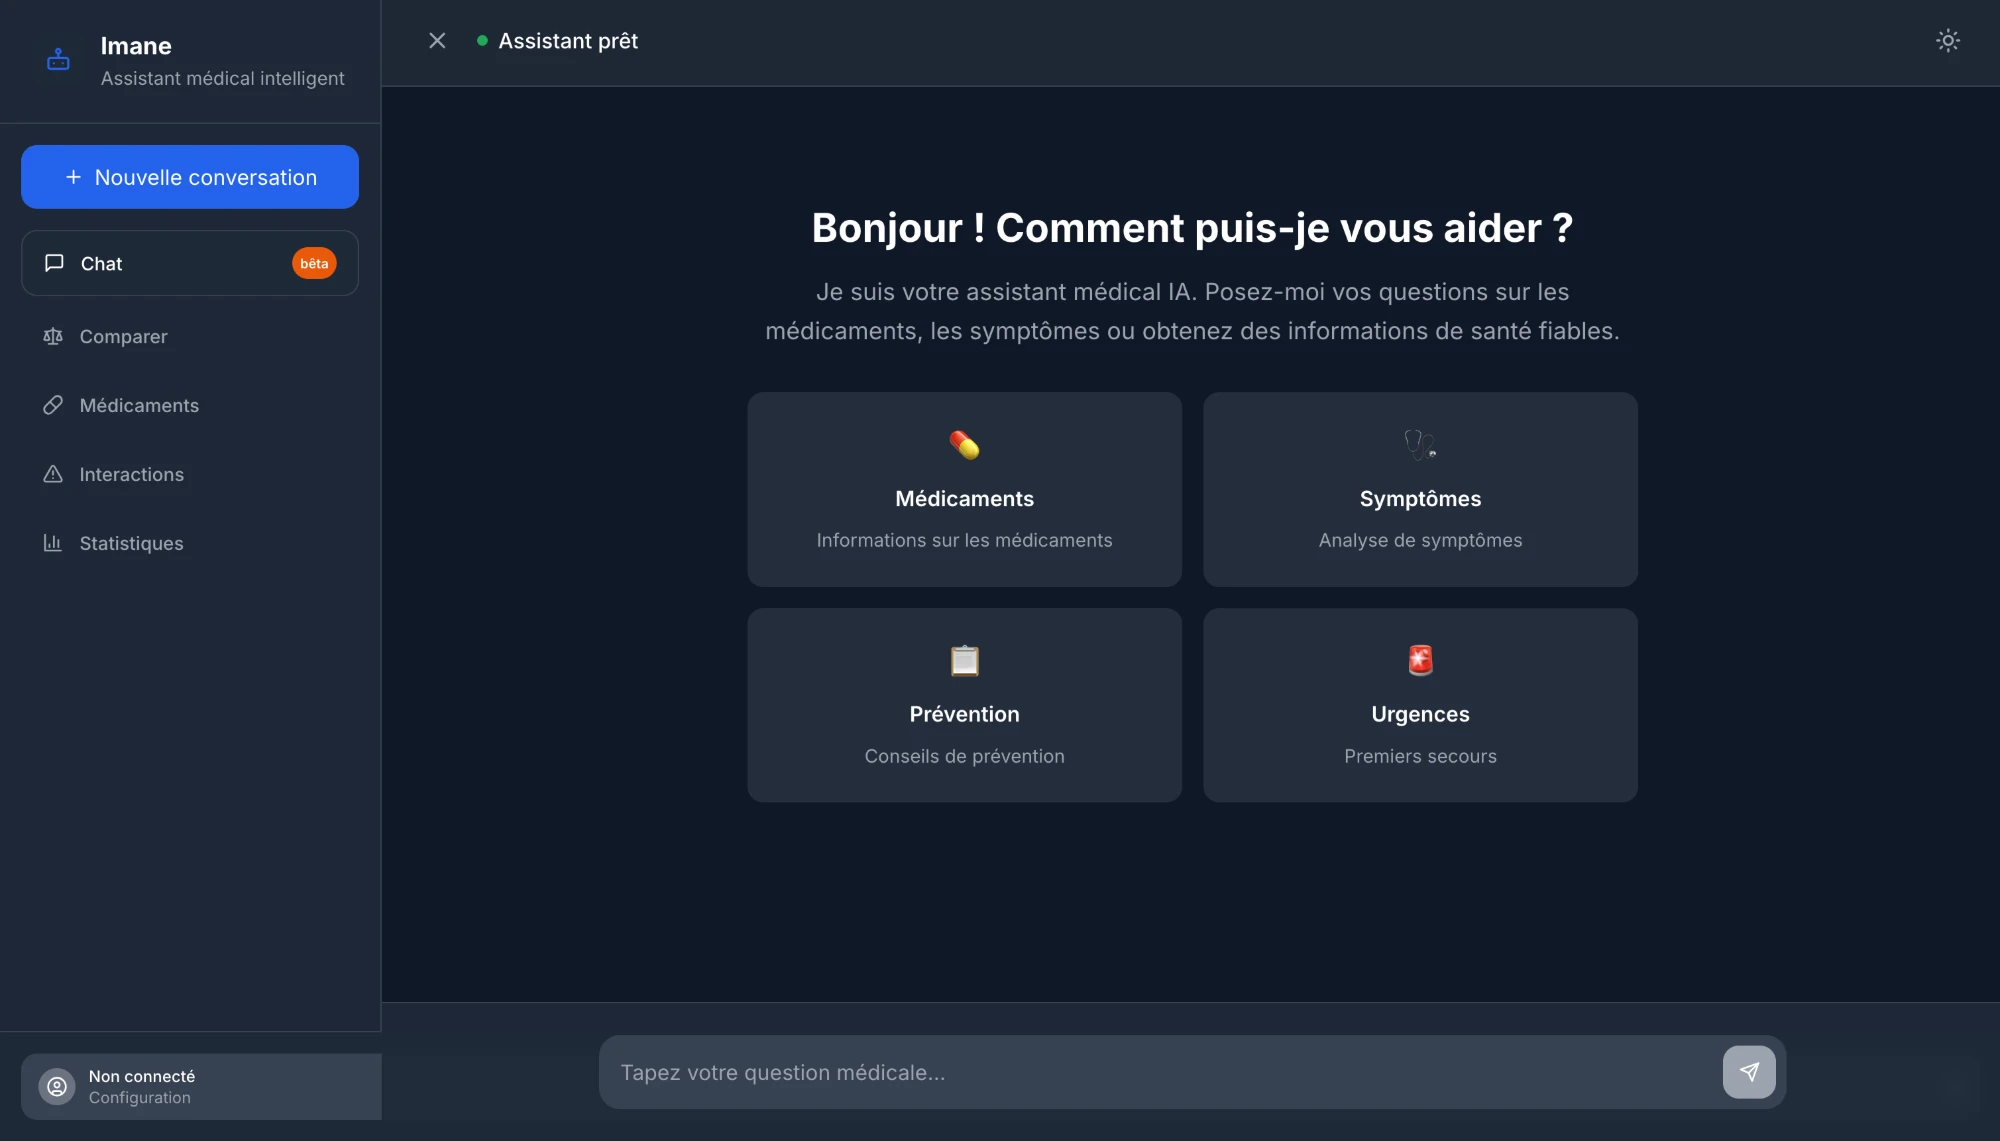 Quatre portes d’entrée pour cadrer la question avant même qu’elle soit posée.
La réponse est structurée par rubrique et la source interrogée est nommée — ici la BDPM. L’onglet Sources donne les documents qui fondent la réponse : sans eux, l’outil ne serait pas utilisable.
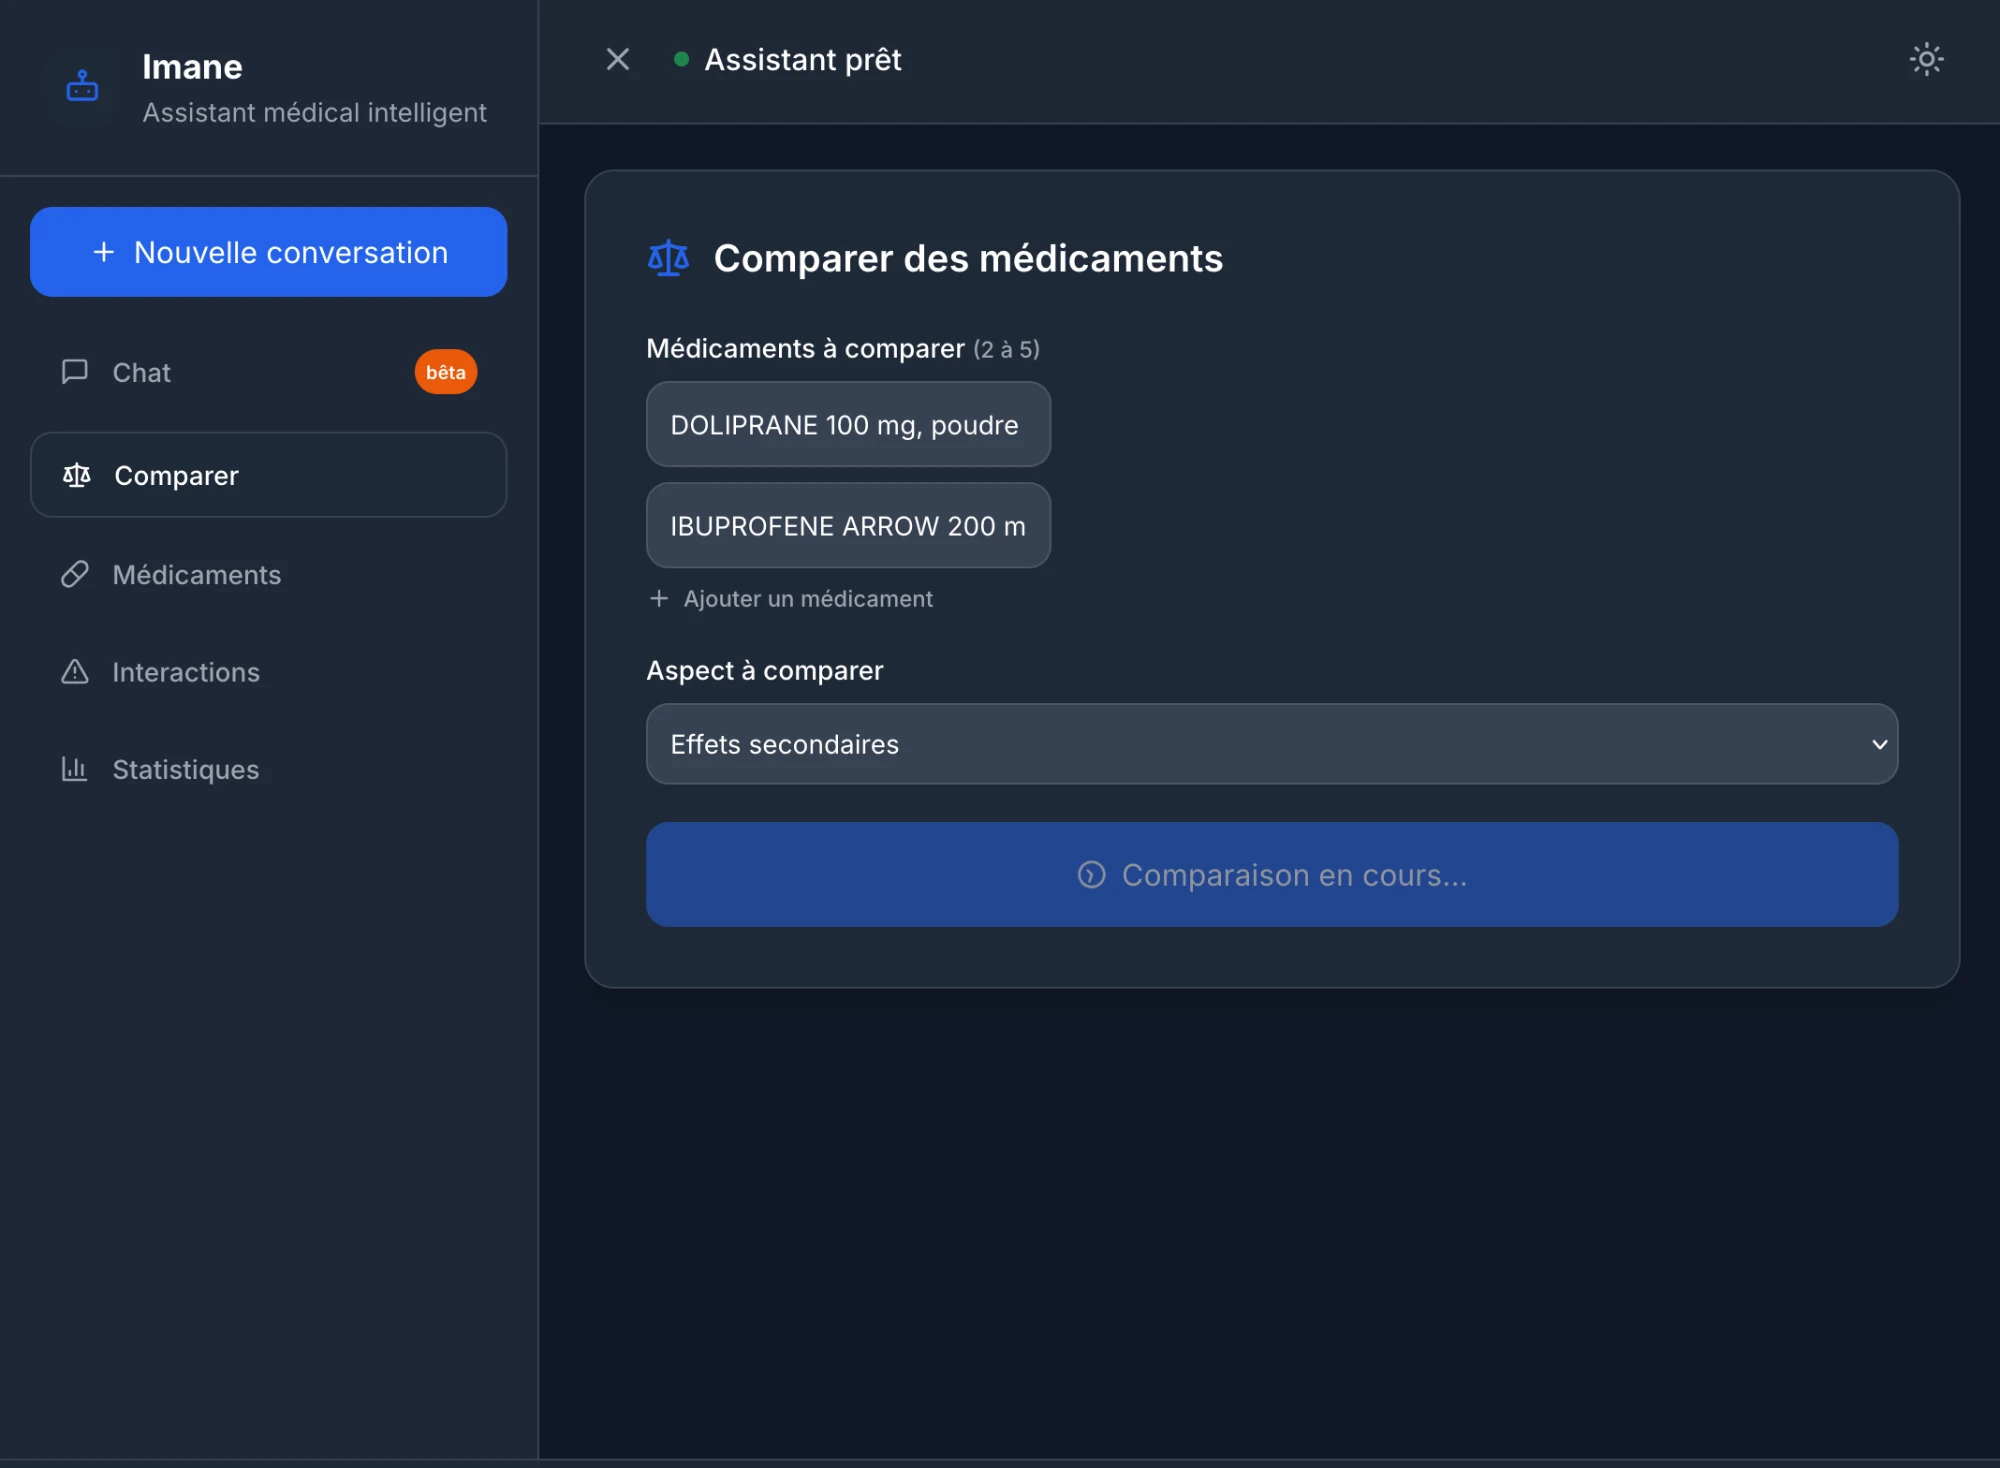 Comparateur : de deux à cinq médicaments, selon un aspect choisi — effets secondaires, interactions, contre-indications.
Back-office
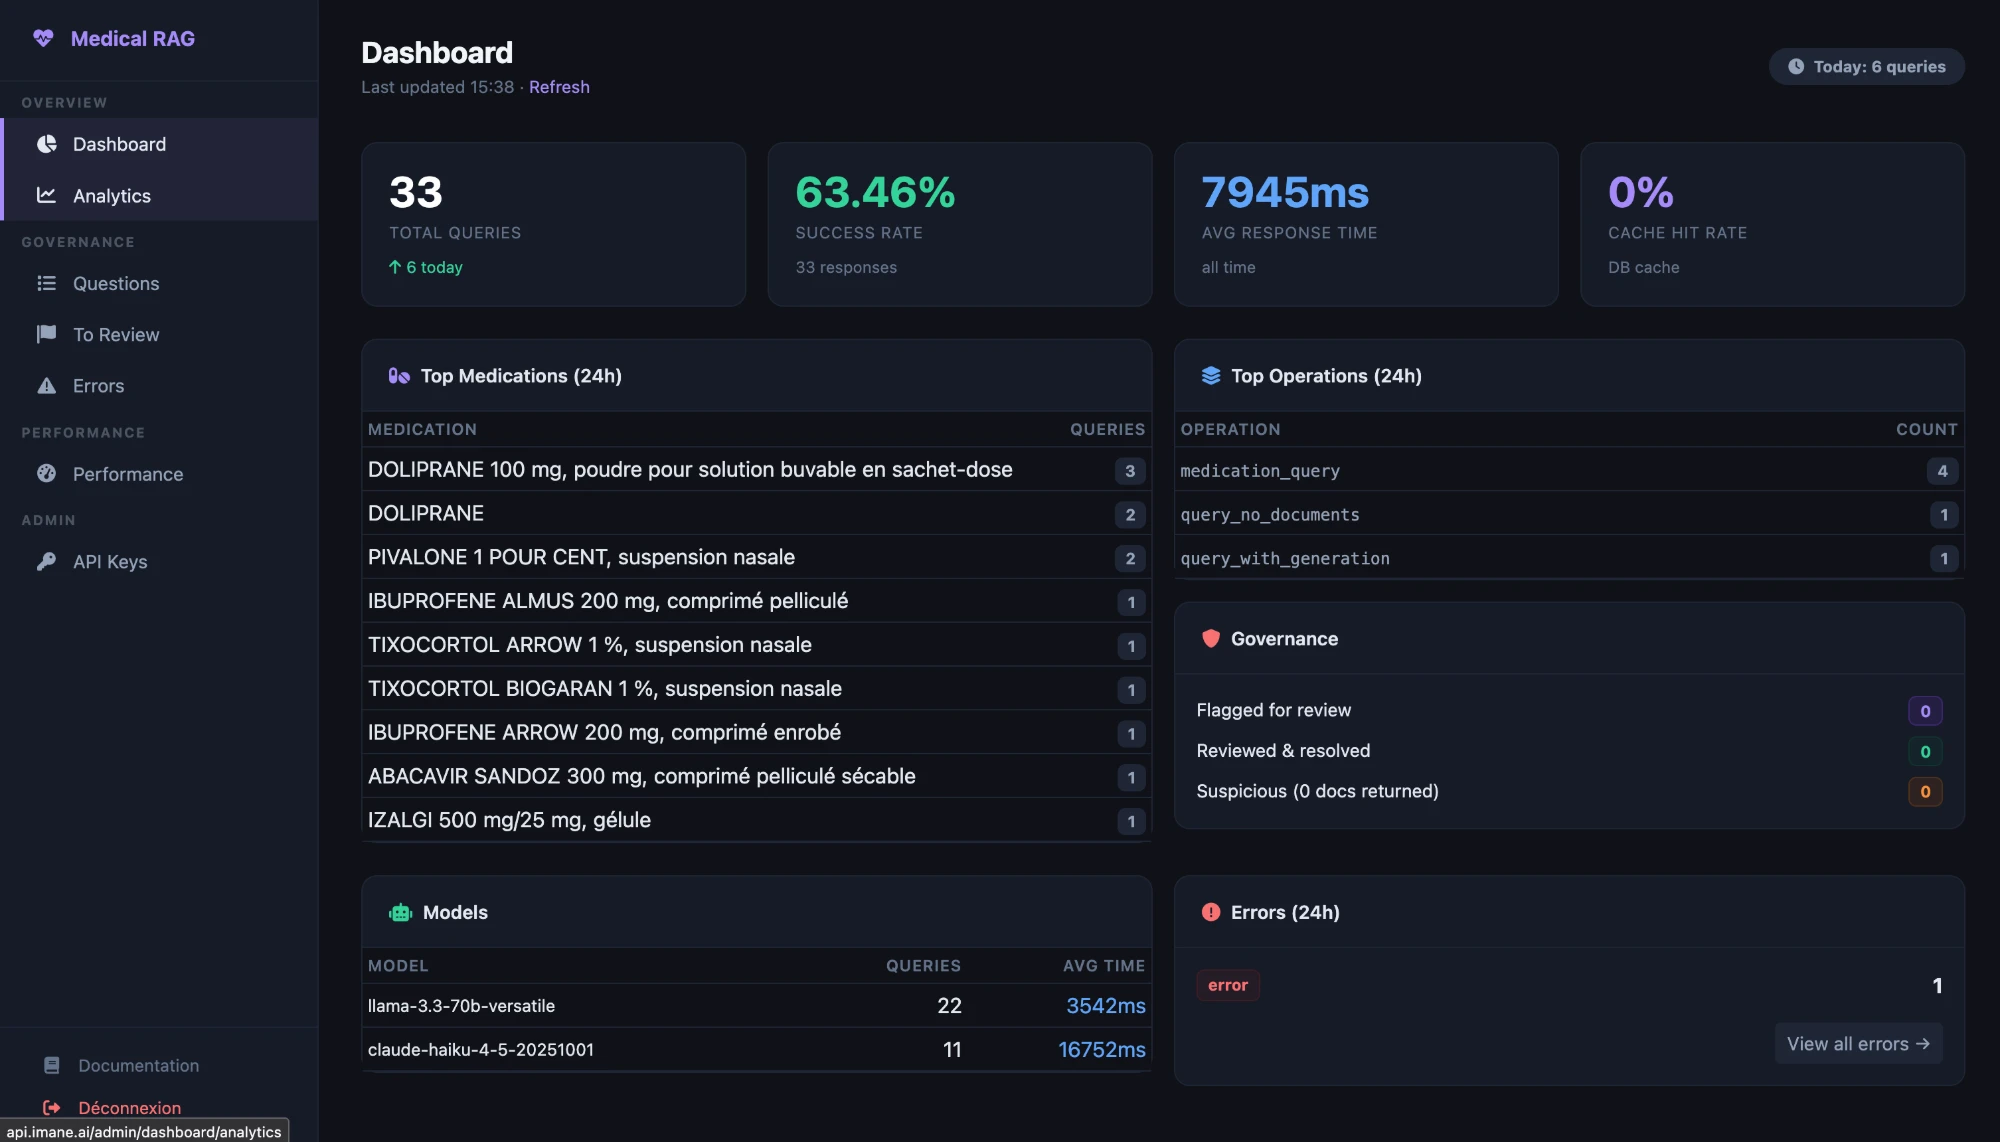 Le suivi par modèle est la partie la plus utile : à qualité comparable, l’écart de latence entre les deux modèles sollicités atteint un facteur cinq.
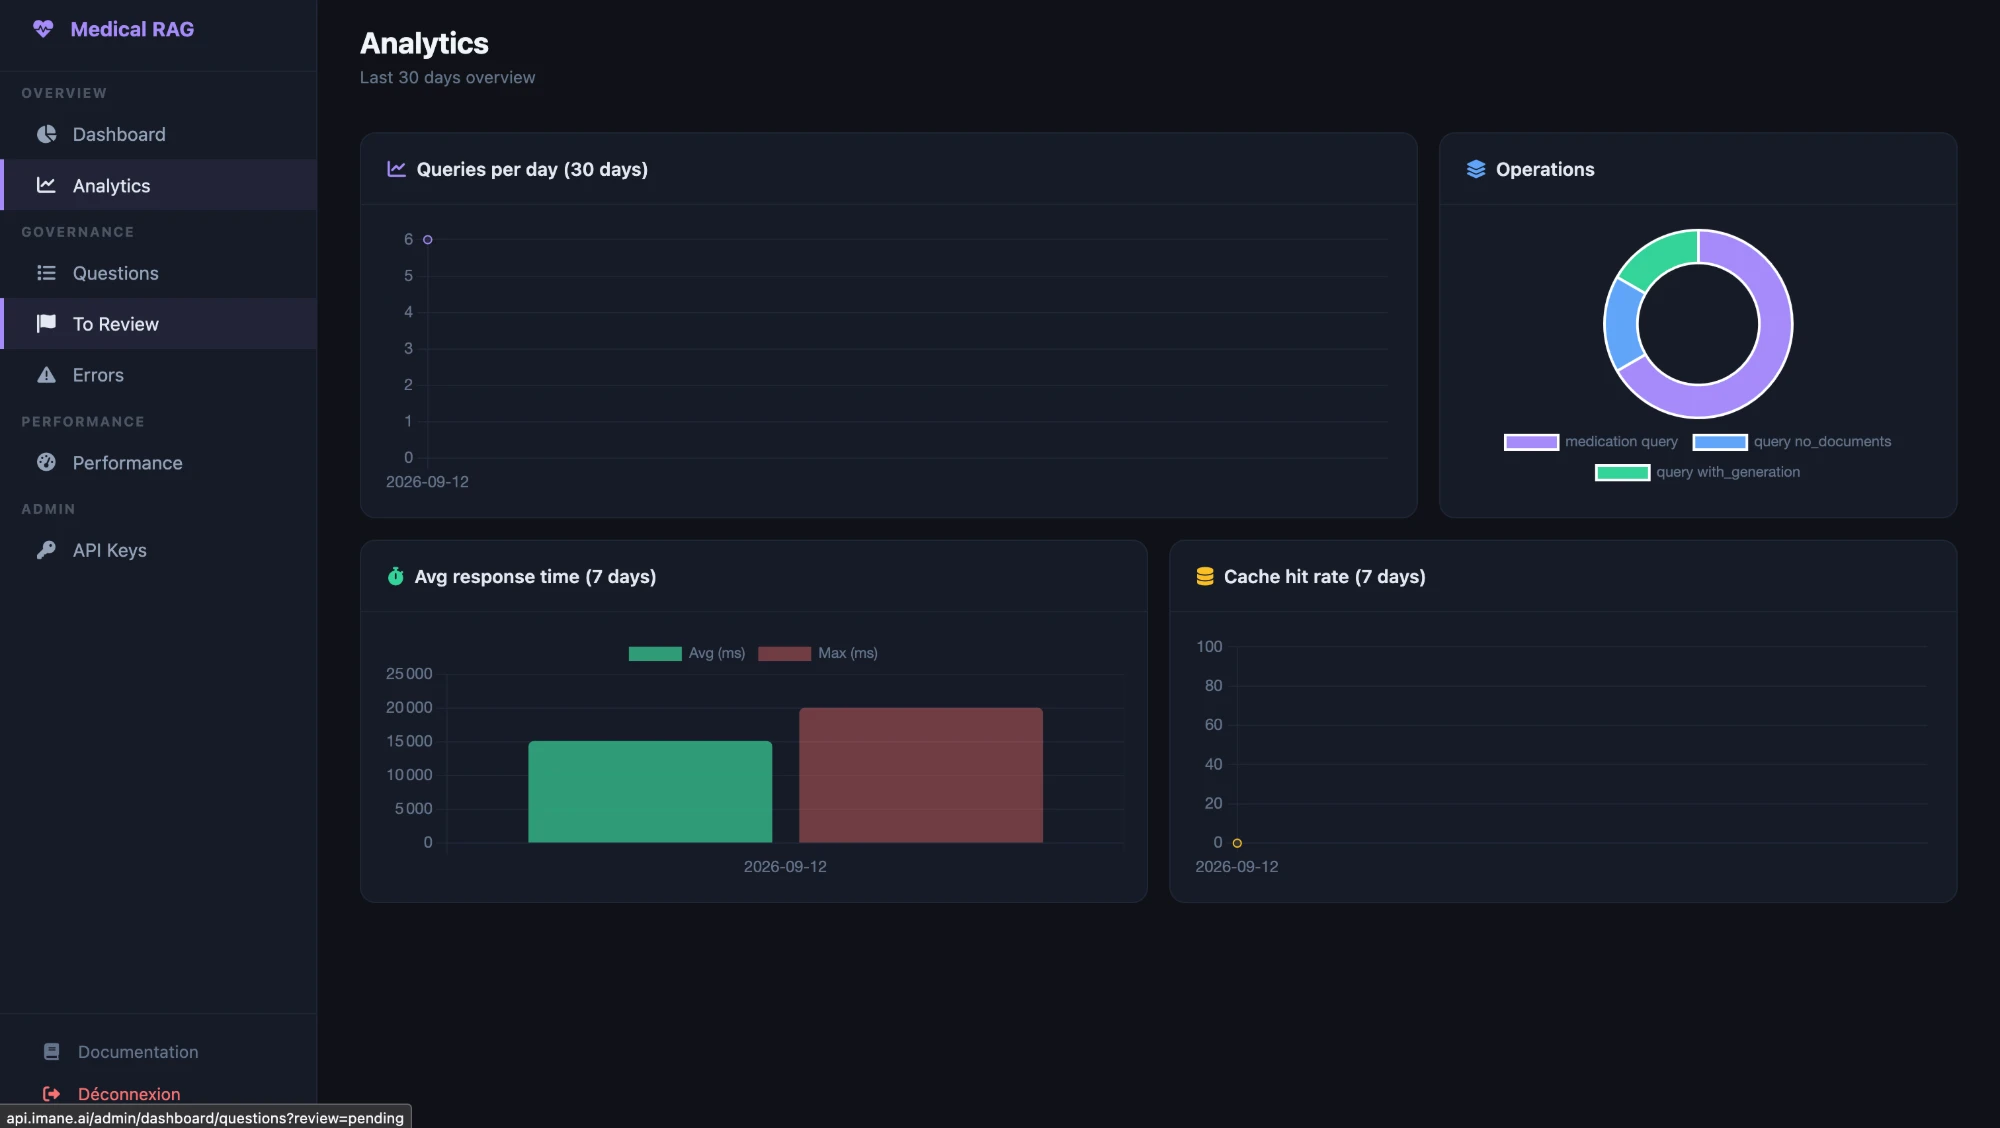 Les opérations sont ventilées entre interrogation de médicament, requête sans document et requête avec génération — la deuxième catégorie signale les trous du corpus.
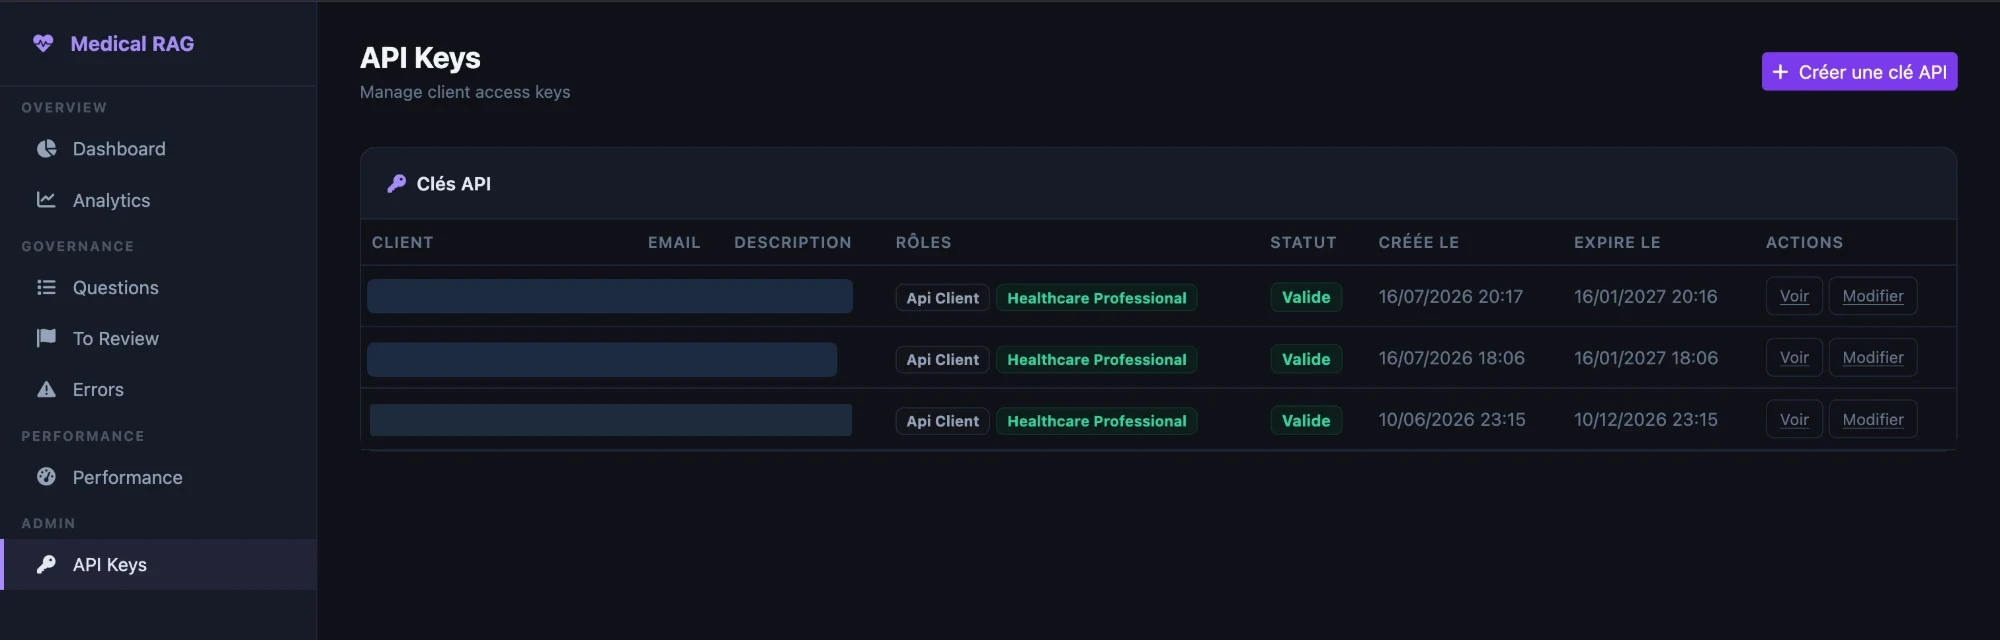 Clés d’API à rôles et à expiration : le RAG est consommé par des applications tierces autant que par l’interface web.